 ESP
 English
Computer Vision Lab
Trabaja con nosotrosQuiénes somos
Somos el Laboratorio de Visión por Computador de la Facultad de Ingeniería y Ciencias Aplicadas de la Universidad de los Andes, Chile. Investigamos aprendizaje autosupervisado y multimodal para que los modelos de visión necesiten menos etiquetas, generalicen mejor y puedan explicarse, y los aplicamos donde importan: imágenes médicas, comprensión de bocetos, documentos históricos y video. Trabajamos con hospitales, empresas y universidades en Chile y el extranjero.
Conoce al equipo →Próximo evento
V Workshop on Computer Vision 2026
IA al servicio del Paciente: avances y desafíos
- Cuándo
- Miércoles 9 de diciembre de 2026, 09:00 a 17:00 horas
- Dónde
- Auditorio B, Biblioteca, Universidad de los Andes, Chile

Noticias
-
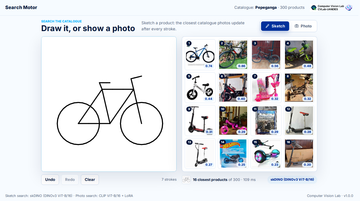
Nueva demo: Search Motor
Busca en un catálogo de e-commerce dibujando un producto o mostrando una foto — skDINO para bocetos y un CLIP ajustado para fotos.
-
Ayúdanos a construir un dataset de bocetos
Ayúdanos a construir un dataset de bocetos
Sketch Gatherer te muestra un objeto y te pide dibujarlo; cada trazo se guarda con su tiempo para nuestros modelos de bocetos.
-
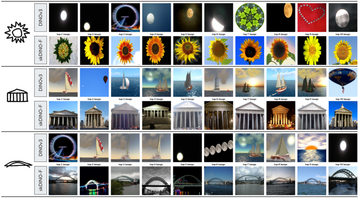
skDINO publicado en CVIU
“DINOv3 meets sketches: a general sketch-photo encoder”, en Computer Vision and Image Understanding. Código, resultados y figuras en la página del proyecto.
-
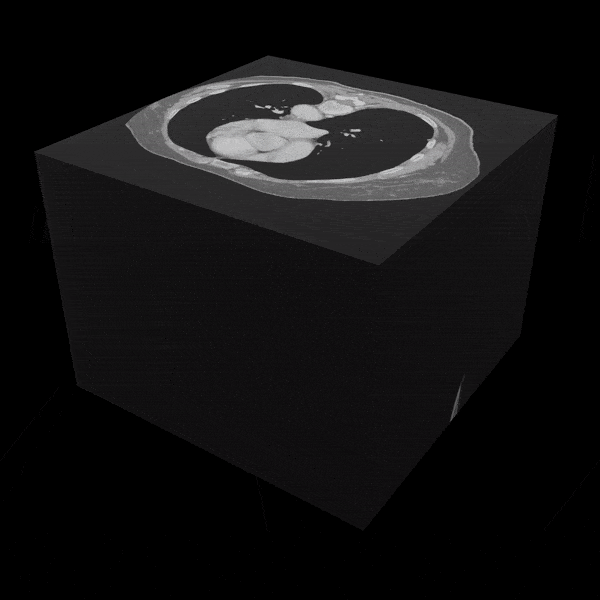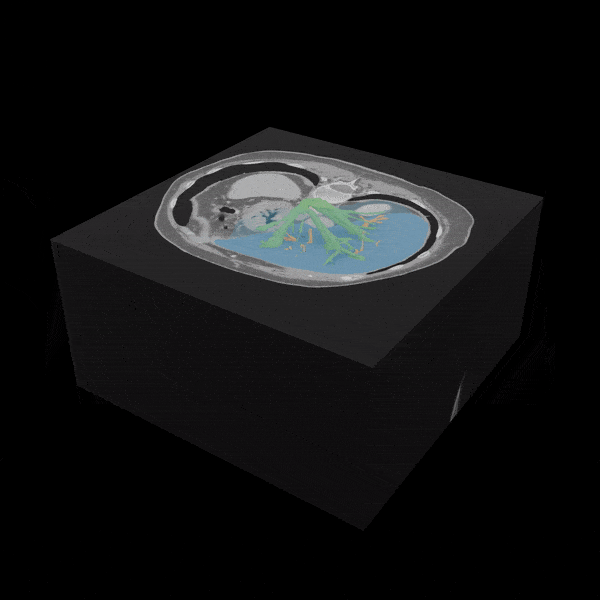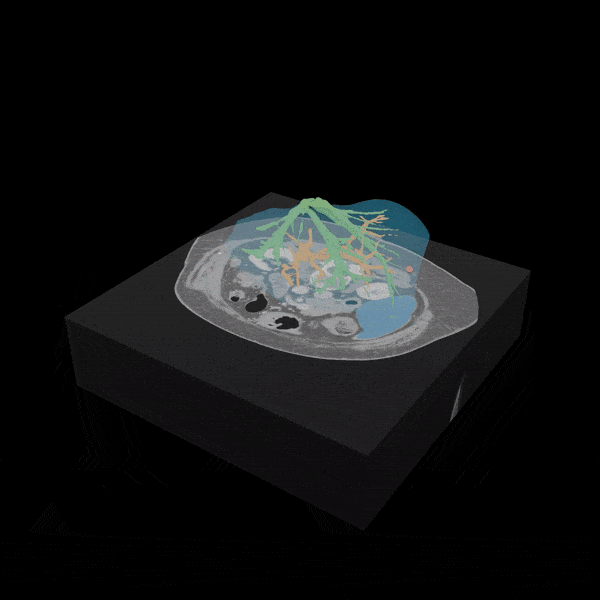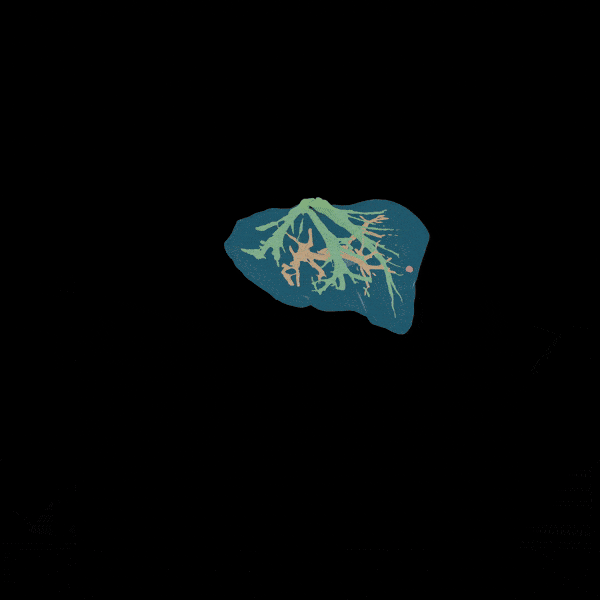
Dos artículos en workshops de MICCAI 2026
Eliminación de ruido en CT de baja dosis en tiempo real con flow matching de un paso (MIRASOL) y masked image modeling sesgado para segmentar anatomía fina (MedAGI).
-
Nuevo proyecto Fondecyt Regular
Nuevo proyecto Fondecyt Regular
Espacios latentes visuales y modelos de lenguaje para hacer interpretables y explicables los modelos de visión.
-
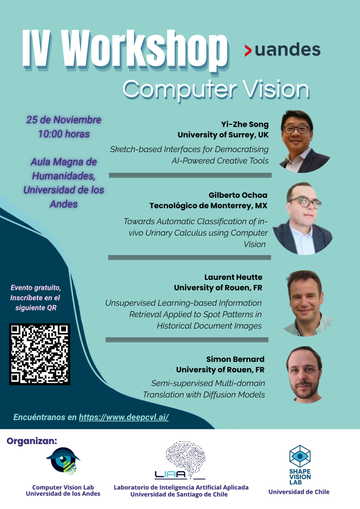
IV Workshop on Computer Vision
Charlas de Yi-Zhe Song (Surrey), Gilberto Ochoa (Tec de Monterrey), Laurent Heutte y Simon Bernard (Rouen), además de charlas de estudiantes y pósters.


Líneas de investigación
Toda la investigación →-
Imágenes médicas
La IA avanza rápido en lenguaje y visión, y la salud es el sector que más puede beneficiarse. Construimos modelos de imágenes médicas multimodales,...
Leer más → -
Comprensión basada en bocetos
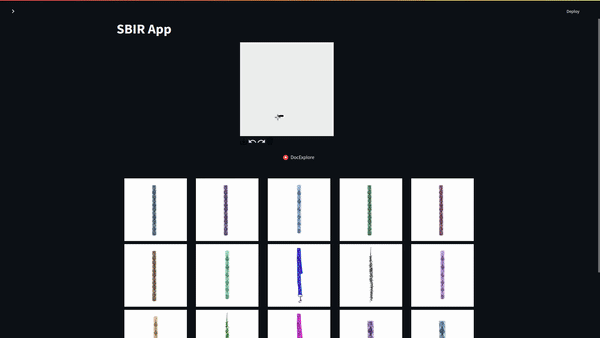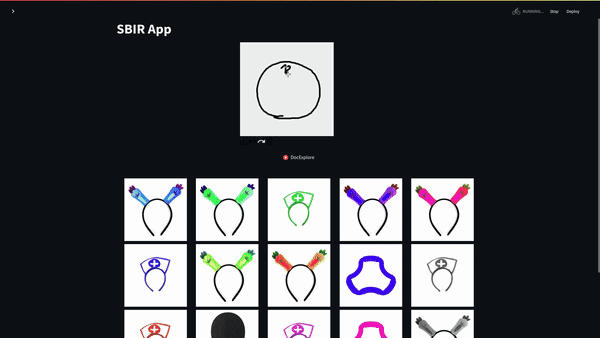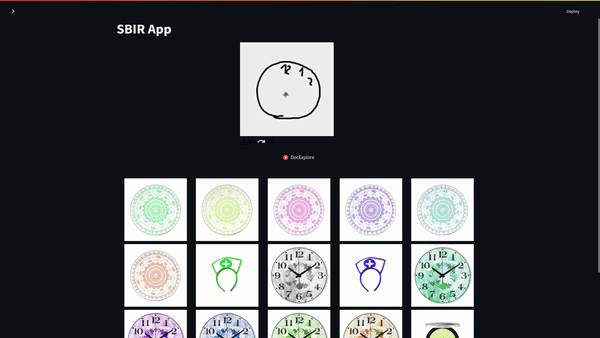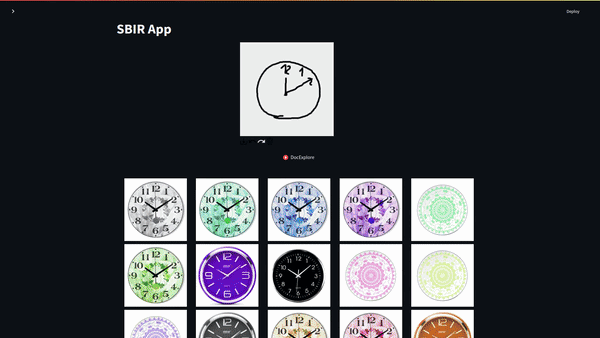
Dibujar es una de las formas más naturales de comunicarnos. Construimos codificadores que entienden bocetos y los conectan con fotografías: para...
Leer más → -
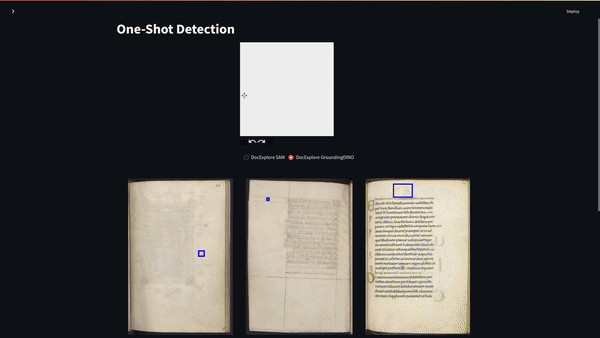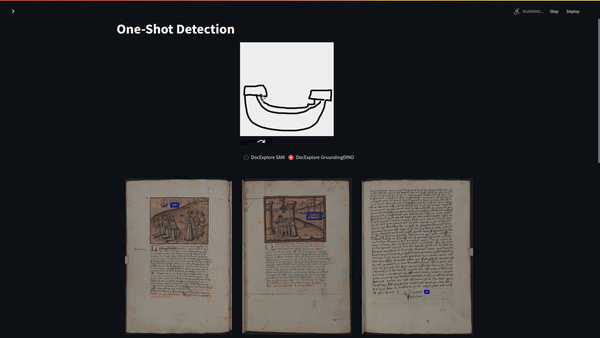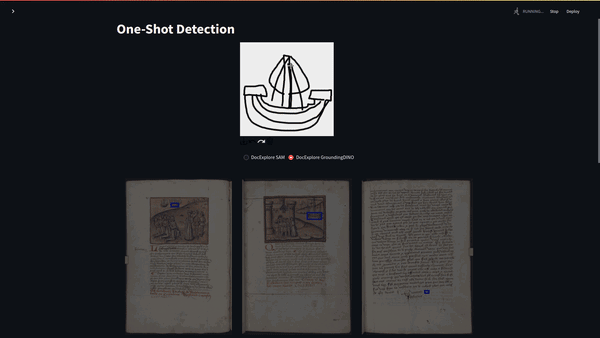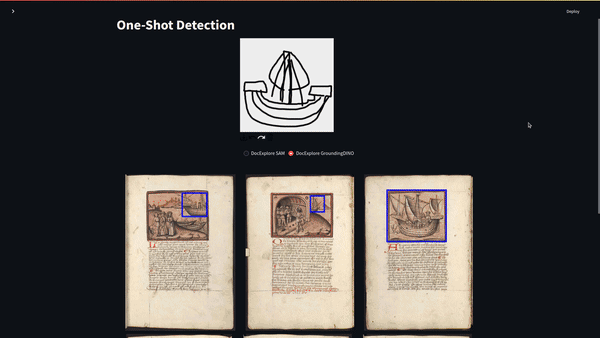
Detección one-shot eficiente
Detectar objetos de clases que el modelo nunca vio, a partir de un solo ejemplo — incluso cuando ese ejemplo es un boceto.
Leer más → -
Modelos generativos
Modelos generativos condicionales — de las GAN a la difusión — que convierten un boceto en una imagen realista, o un CT de baja dosis en uno de...
Leer más → -
Análisis de video
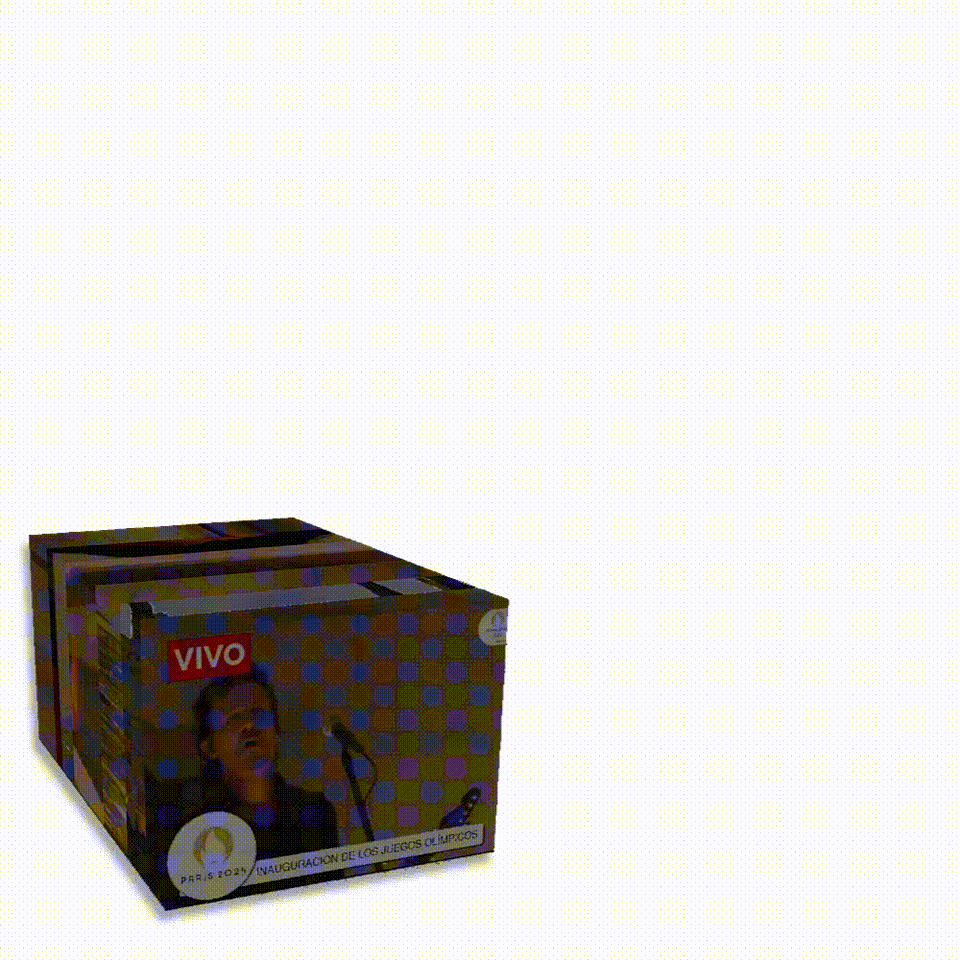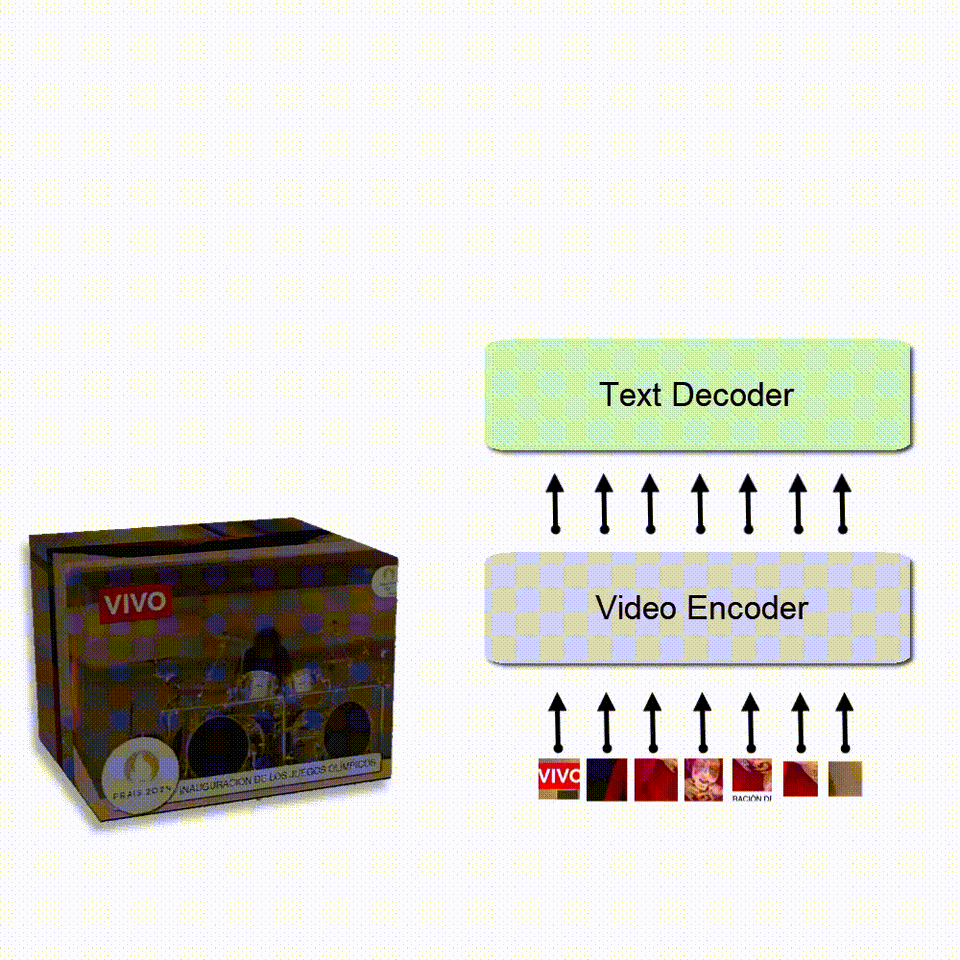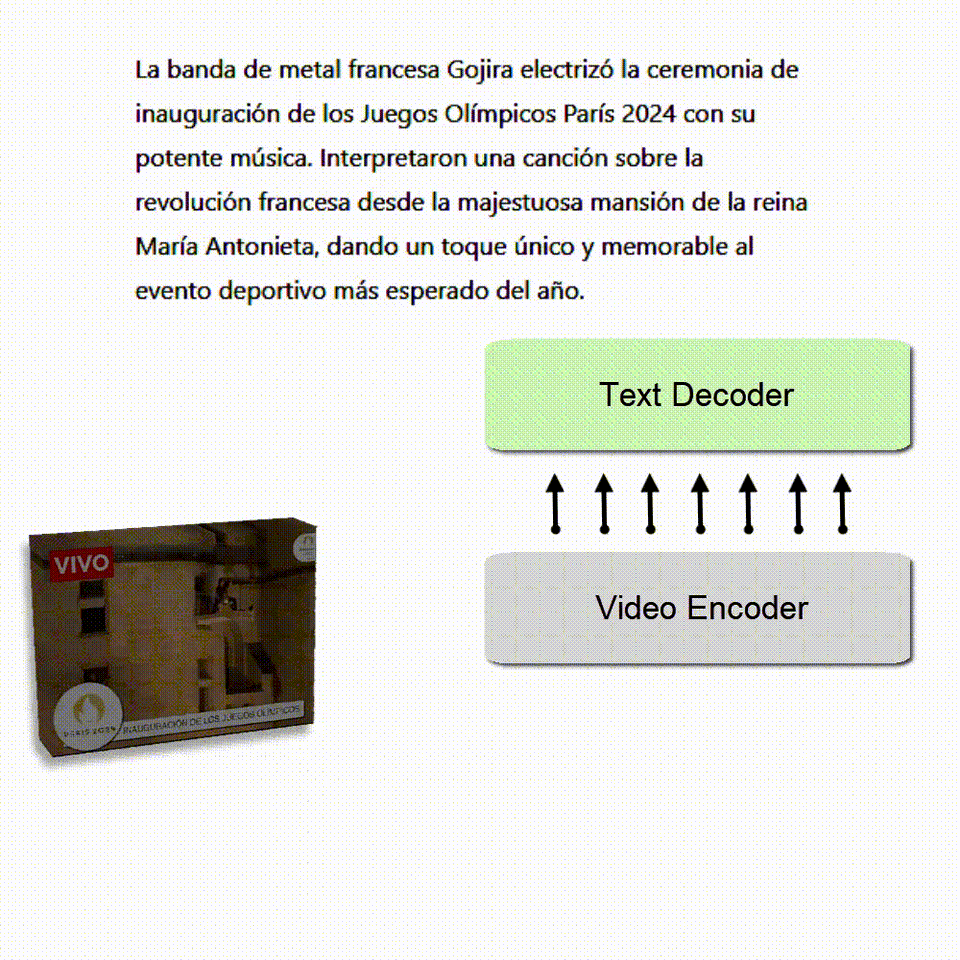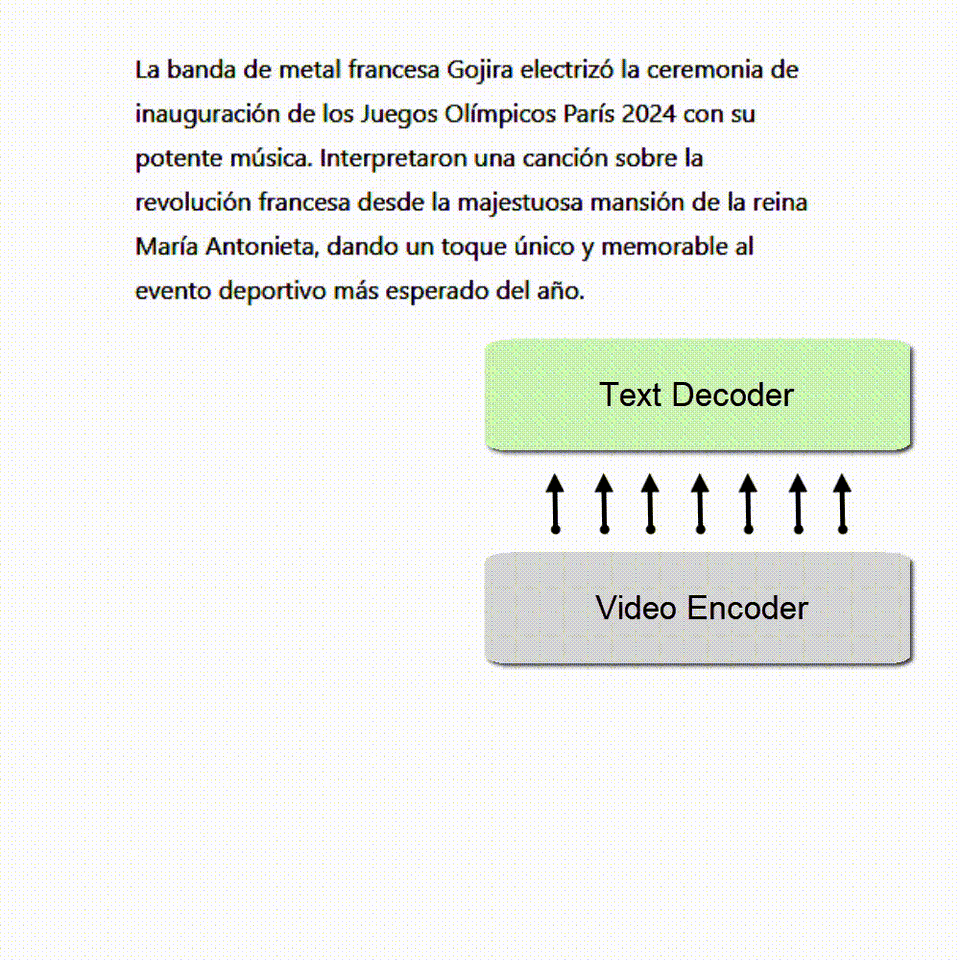
Modelos que describen video en condiciones reales — noticias, deportes, streaming — y que permiten buscar en catálogos de video con un boceto.
Leer más →


Publicaciones recientes
Todas las publicaciones →-
DINOv3 meets sketches: A general sketch-photo encoder
Computer Vision and Image Understanding (CVIU), 2026
-
LDCT-to-SDCT as a Bridge Problem: Single-Step Residual Endpoint Flow Matching for Real-Time Denoising
To appear in MIRASOL, MICCAI, 2026
-
B-MIM: Biased Masked Image Modeling for Generalizable Segmentation of Fine-Grained Anatomical Structures
To appear in MedAGI, MICCAI 2026
-
A Study of Cross-Dataset Generalization on Liver Vessel Segmentation Improved by a Topological Loss
Medical and Biological Engineering and Computing (2026)